從 ChatGPT、Gemini 到 Claude,生成式 AI 已經融入我們的日常生活。無論是撰寫 Email、翻譯文章、整理資料或是程式設計,只要輸入一段文字,AI 就能在短時間內提供回應。
但你是否想過,當我們向 AI 提問時,它究竟是如何『閱讀』這些文字的?
在 AI 或 API 的工具使用中,一定會出現一個名詞:Token。
它不是字數,也不完全等於單字數量,卻是大型語言模型(LLM)處理文字的重要基礎,更與 AI 的使用量、成本及對話長度有關。
01 | Token 是什麼?
簡單來說,Token 是 AI 語言模型用來處理文字的基本單位。
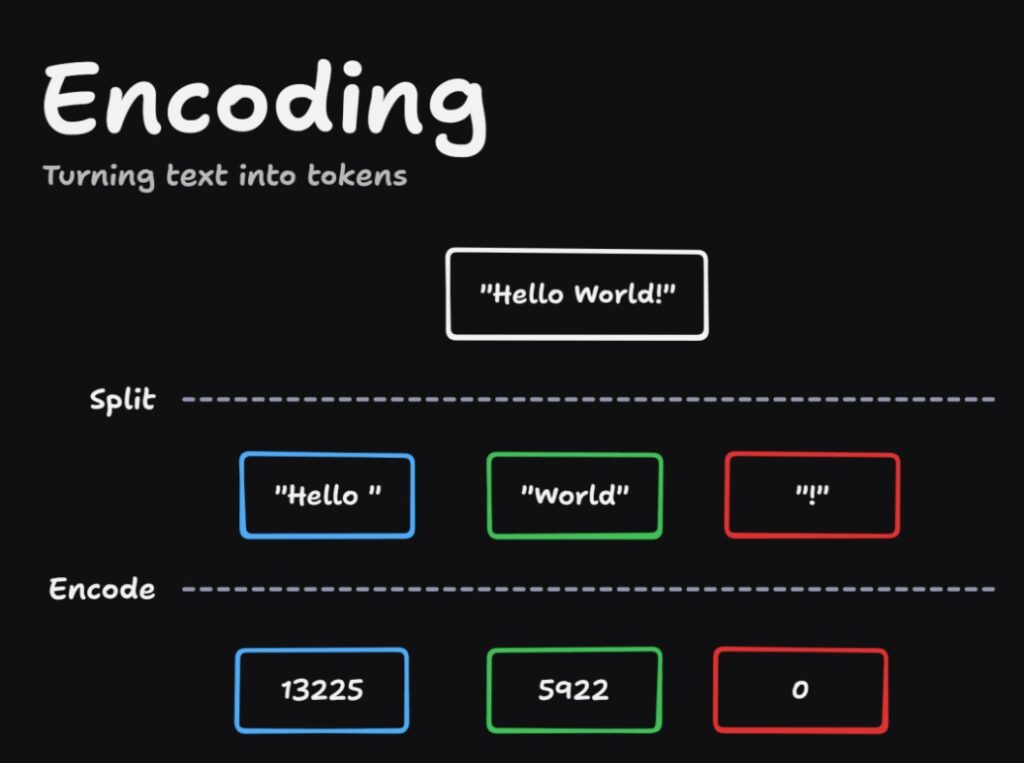
我們習慣以『字』或『詞』理解語言,但 AI 並不是直接按照人類的閱讀方式處理文字。當你輸入一句話時系統會先透過稱為 Tokenizer(分詞器)的工具,將文字拆分成一個個 Token,在轉換成模型可以處理的數字編號。
例如:I love design.
這句話在某些模型中,可被拆分為:I / love / design / .
每個部分都是一個 Token,即為4個 Token。
而對人類來說這句話是11個字加上一個標點符號。
不過 Token 的切分方式並沒有統一標準。不同 AI 模型可能使用不同的 Tokenizer [1],因此相同的文字,在不同模型中也可能產生不同的 Token 數量,而不同的語言所消耗的 Token 數也會不一樣。由此可知,Token 不是單純的字數,而是 AI 處理語言時使用的編碼單位。
02 | 一個 Token 等於多少字?
這是認識 Token 時最常見的問題。以英文來說,OpenAI 曾提供一個方便理解的粗略估算:
1 個 Token 約等於 4 個英文字元,或約 0.75 個英文單字。
但這只是估算值,並不是每個模型都適用的固定公式。例如常見的英文單字可能只需要一個 Token,較長或少見的單字則可能被拆分成數個部分。中文的情況又有所不同,由於中文字的編碼方式與英文不同,一個中文字可能對應一個或多個 Token,常見詞組也可能被合併處理。
因此,一遍500字的中文文章,不代表只會消耗500個 Token。同樣的內容翻譯成英文後,Token 數量也會改變,但不能一概認定英文一定比較省。如果想知道某段文字實際包含多少 Token,可以透過模型對應的 Tokenizer 工具進行測試。
03 | 為什麼 AI 要把文字拆成 Token?
對人類來說,閱讀一句話是很自然的事,但電腦需要先將文字轉成數字才能進一步運算。Token 就是這個轉換過程中的重要環節。當你輸入『幫我推薦三種適合小坪數住宅的家具』時,AI 會先將文字轉換成 Token,再根據模型學習到的語言模式與上下文,逐步產生回覆。
大型語言模型並不是先在電腦中寫好一整篇文章,再一次顯示出來,而是依照前面的內容,持續預測並選擇後續的 Token。這也是為什麼我們使用 ChatGPT 時,經常會看到文字一段段出現在畫面上。
不過這不代表 AI 只是機械式地接龍。大型語言模型可以透過複雜的神經網路運算,處理語意、上下文及不同概念之間的關係。Token 則是讓這些語言資訊得以進入模型運算的基礎。
04 | Token 和 AI 使用費用有什麼關係?
我們都知道許多 AI 工具都有免費版、付費訂閱版,或不同的使用額度。這些服務背後的成本,與模型需要處理多少資訊有關。對許多以 API [2] 提供服務的語言模型而言,Token 是計算使用量的重要依據,通常會區分為兩種:
Input Token(輸入 Token):使用者提供給 AI 的內容,例如問題、文章、指令,以及實際送入模型的其他上下文。
Output Token(輸出 Token):AI 產生回覆時使用的 Token。
舉例來說,當你請 AI 將一篇長文章整理成三個重點,模型需要先處理原始文章,再產生摘要。因此,即使最後只得到短短幾句回覆,輸入的文章仍然會占用 Token。不過這不代表所有 AI 工具都直接按照 Token 向一般使用者收費。像 ChatGPT、Gemini 等消費者訂閱服務通常會依照方案提供不同的功能與使用限制。Token 計價主要常見於開發者使用的 API 服務。
05 | 為什麼和 AI 聊越久,有時候反而越容易忘記前面的內容?
你是否曾遇過這種情況?一開始和 AI 討論得很順利,但對話持續一段時間後,它卻忘記先前提出的要求,甚至給出與原本方向不同的回答。這與 AI 的上下文處理方式有關。
大型語言模型具有一個成為 Context Window(上下文視窗)的概念,可以理解為模型單次處理資訊的容量範圍,通常以 Token 數量衡量。在多輪對話中,AI 可能需要同時參考先前的討論、本次問題,以及其他相關資訊。當內容越來越多,就可能接近模型的上下文限制。
不同 AI 服務會透過保留部分歷史記錄、摘要或其他方式管理對話,因此不一定會將所有內容完整保留下來。即使尚未達到上限,過長或混雜的對話也可能讓模型難以準確掌握所有要求。因此,如果討論已經累積很多不同主題,適時整理重點、開一個新對話窗重新說明需求,往往能讓後續溝通更清楚。
06 | 圖片和聲音也有 Token 嗎?
隨著 AI 技術發展,現在的模型已經不只能處理文字。我們可以上傳圖片請 AI 分析,也能透過語音與 AI 對話,甚至讓模型理解影片內容。這類能夠處理多種資訊形式的技術,稱為 Multimodal AI(多模態人工智慧)。
在部分多模態模型中,圖片、聲音和影片也會轉換成模型可以處理的資訊單位,並以 Token 衡量使用量。不過圖片與音訊的計算方式不一定和文字相同。
例如,一張圖片可能因解析度、模型架構與處理方式不同,產生不同的 Token 數量;音訊則可能與錄音長度及模型類型有關。因此,不能直接將一張圖片換算成固定數量的文字 Token。這也反映了 Token 概念的延伸:AI 處理的資訊越來越多元,而不同形式的資料也需要各自的編碼與運算方式。
07 | 了解 Token 能讓我們更有效地使用 AI 嗎?
答案是肯定的,但不代表每次輸入指令前都需要仔細計算 Token。對一般使用者而言,更重要的是理解:輸入內容的長度、清楚程度與相關性,都會影響 AI 的處理過程。
例如,當你想請 AI 協助規劃居家空間時,與其只輸入:『幫我設計一個客廳』,不如提供更完整的需求:『規劃一個適合兩人居住的6坪客廳,風格以現代簡約為主,需要收納空間、雙人沙發與閱讀角落』。
第二段指令雖然使用更多 Token,卻提供了更清楚的條件,通常更有機會得到符合需求的建議。同樣地,過度冗長、重複或與任務無關的內容,也可能增加不必要的處理負擔。因此,使用 AI 時不需要一味追求最短的 Prompt,而是應該讓指令保持清楚、具體,並提供真正需要的資訊。
——
[1] Tokenizer:https://huggingface.co/learn/llm-course/zh-TW/chapter2/4
[2] API:https://user256868.pse.is/9rzp6v
——
圖文整理自網路
#AI #Token